background-image: url(images/logo.png), url(images/afri_logo.png) background-position: 0% 100%, 100% 0% background-size: 10%, 10% class: title-page, center, middle ## String manipulation using forstringr package <div> <style type="text/css">.xaringan-extra-logo { width: 110px; height: 128px; z-index: 0; background-image: url(images/logo.png); background-size: contain; background-repeat: no-repeat; position: absolute; top:1em;right:1em; } </style> <script>(function () { let tries = 0 function addLogo () { if (typeof slideshow === 'undefined') { tries += 1 if (tries < 10) { setTimeout(addLogo, 100) } } else { document.querySelectorAll('.remark-slide-content:not(.title-page):not(.inverse):not(.hide_logo)') .forEach(function (slide) { const logo = document.createElement('a') logo.classList = 'xaringan-extra-logo' logo.href = 'https://bit.ly/gbganalyst' slide.appendChild(logo) }) } } document.addEventListener('DOMContentLoaded', addLogo) })()</script> </div> --- class: about-me-slide, inverse, middle, center ## About Me <img style="border-radius: 80%;" src="images/passport_new.jpg" width="180px"/> ### Ezekiel Adebayo Ogundepo #### Data Specialist .fade[54gene<br>Lagos, Nigeria] [<svg viewBox="0 0 512 512" style="height:1em;position:relative;display:inline-block;top:.1em;" xmlns="http://www.w3.org/2000/svg"> <path d="M326.612 185.391c59.747 59.809 58.927 155.698.36 214.59-.11.12-.24.25-.36.37l-67.2 67.2c-59.27 59.27-155.699 59.262-214.96 0-59.27-59.26-59.27-155.7 0-214.96l37.106-37.106c9.84-9.84 26.786-3.3 27.294 10.606.648 17.722 3.826 35.527 9.69 52.721 1.986 5.822.567 12.262-3.783 16.612l-13.087 13.087c-28.026 28.026-28.905 73.66-1.155 101.96 28.024 28.579 74.086 28.749 102.325.51l67.2-67.19c28.191-28.191 28.073-73.757 0-101.83-3.701-3.694-7.429-6.564-10.341-8.569a16.037 16.037 0 0 1-6.947-12.606c-.396-10.567 3.348-21.456 11.698-29.806l21.054-21.055c5.521-5.521 14.182-6.199 20.584-1.731a152.482 152.482 0 0 1 20.522 17.197zM467.547 44.449c-59.261-59.262-155.69-59.27-214.96 0l-67.2 67.2c-.12.12-.25.25-.36.37-58.566 58.892-59.387 154.781.36 214.59a152.454 152.454 0 0 0 20.521 17.196c6.402 4.468 15.064 3.789 20.584-1.731l21.054-21.055c8.35-8.35 12.094-19.239 11.698-29.806a16.037 16.037 0 0 0-6.947-12.606c-2.912-2.005-6.64-4.875-10.341-8.569-28.073-28.073-28.191-73.639 0-101.83l67.2-67.19c28.239-28.239 74.3-28.069 102.325.51 27.75 28.3 26.872 73.934-1.155 101.96l-13.087 13.087c-4.35 4.35-5.769 10.79-3.783 16.612 5.864 17.194 9.042 34.999 9.69 52.721.509 13.906 17.454 20.446 27.294 10.606l37.106-37.106c59.271-59.259 59.271-155.699.001-214.959z"></path></svg> https://bit.ly/gbganalyst](https://bit.ly/gbganalyst) [<svg viewBox="0 0 512 512" style="height:1em;position:relative;display:inline-block;top:.1em;" xmlns="http://www.w3.org/2000/svg"> <path d="M459.37 151.716c.325 4.548.325 9.097.325 13.645 0 138.72-105.583 298.558-298.558 298.558-59.452 0-114.68-17.219-161.137-47.106 8.447.974 16.568 1.299 25.34 1.299 49.055 0 94.213-16.568 130.274-44.832-46.132-.975-84.792-31.188-98.112-72.772 6.498.974 12.995 1.624 19.818 1.624 9.421 0 18.843-1.3 27.614-3.573-48.081-9.747-84.143-51.98-84.143-102.985v-1.299c13.969 7.797 30.214 12.67 47.431 13.319-28.264-18.843-46.781-51.005-46.781-87.391 0-19.492 5.197-37.36 14.294-52.954 51.655 63.675 129.3 105.258 216.365 109.807-1.624-7.797-2.599-15.918-2.599-24.04 0-57.828 46.782-104.934 104.934-104.934 30.213 0 57.502 12.67 76.67 33.137 23.715-4.548 46.456-13.32 66.599-25.34-7.798 24.366-24.366 44.833-46.132 57.827 21.117-2.273 41.584-8.122 60.426-16.243-14.292 20.791-32.161 39.308-52.628 54.253z"></path></svg> @gbganalyst](https://twitter.com/gbganalyst) [<svg viewBox="0 0 496 512" style="position:relative;display:inline-block;top:.1em;height:1em;" xmlns="http://www.w3.org/2000/svg"> <path d="M165.9 397.4c0 2-2.3 3.6-5.2 3.6-3.3.3-5.6-1.3-5.6-3.6 0-2 2.3-3.6 5.2-3.6 3-.3 5.6 1.3 5.6 3.6zm-31.1-4.5c-.7 2 1.3 4.3 4.3 4.9 2.6 1 5.6 0 6.2-2s-1.3-4.3-4.3-5.2c-2.6-.7-5.5.3-6.2 2.3zm44.2-1.7c-2.9.7-4.9 2.6-4.6 4.9.3 2 2.9 3.3 5.9 2.6 2.9-.7 4.9-2.6 4.6-4.6-.3-1.9-3-3.2-5.9-2.9zM244.8 8C106.1 8 0 113.3 0 252c0 110.9 69.8 205.8 169.5 239.2 12.8 2.3 17.3-5.6 17.3-12.1 0-6.2-.3-40.4-.3-61.4 0 0-70 15-84.7-29.8 0 0-11.4-29.1-27.8-36.6 0 0-22.9-15.7 1.6-15.4 0 0 24.9 2 38.6 25.8 21.9 38.6 58.6 27.5 72.9 20.9 2.3-16 8.8-27.1 16-33.7-55.9-6.2-112.3-14.3-112.3-110.5 0-27.5 7.6-41.3 23.6-58.9-2.6-6.5-11.1-33.3 2.6-67.9 20.9-6.5 69 27 69 27 20-5.6 41.5-8.5 62.8-8.5s42.8 2.9 62.8 8.5c0 0 48.1-33.6 69-27 13.7 34.7 5.2 61.4 2.6 67.9 16 17.7 25.8 31.5 25.8 58.9 0 96.5-58.9 104.2-114.8 110.5 9.2 7.9 17 22.9 17 46.4 0 33.7-.3 75.4-.3 83.6 0 6.5 4.6 14.4 17.3 12.1C428.2 457.8 496 362.9 496 252 496 113.3 383.5 8 244.8 8zM97.2 352.9c-1.3 1-1 3.3.7 5.2 1.6 1.6 3.9 2.3 5.2 1 1.3-1 1-3.3-.7-5.2-1.6-1.6-3.9-2.3-5.2-1zm-10.8-8.1c-.7 1.3.3 2.9 2.3 3.9 1.6 1 3.6.7 4.3-.7.7-1.3-.3-2.9-2.3-3.9-2-.6-3.6-.3-4.3.7zm32.4 35.6c-1.6 1.3-1 4.3 1.3 6.2 2.3 2.3 5.2 2.6 6.5 1 1.3-1.3.7-4.3-1.3-6.2-2.2-2.3-5.2-2.6-6.5-1zm-11.4-14.7c-1.6 1-1.6 3.6 0 5.9 1.6 2.3 4.3 3.3 5.6 2.3 1.6-1.3 1.6-3.9 0-6.2-1.4-2.3-4-3.3-5.6-2z"></path></svg> @gbganalyst](https://github.com/gbganalyst) --- class: inverse, middle, center ## Why `forstringr` package? <img src="images/logo.png" width="30%" height="25%" style="display: block; margin: auto;" /> --- class: middle ## Why `forstringr` package? <img src="images/stackoverflow_1.png" width="1600" style="display: block; margin: auto;" /> Source: [stackoverflow](https://stackoverflow.com/questions/15897236/extract-the-first-or-last-n-characters-of-a-string/63615311#63615311) --- class: middle ## Why `forstringr` package? <img src="images/stackoverflow_2.png" width="1487" style="display: block; margin: auto;" /> Source: [stackoverflow](https://stackoverflow.com/questions/7963898/extracting-the-last-n-characters-from-a-string-in-r/63615027#63615027) --- class: middle, hide_logo .w-100.lh-copy[ Goal: > The goal of forstringr is to enable complex string manipulation in R easier for the beginners. The package combines the power of stringr with other manipulation packages such as dplyr and tidyr. Just like in the stringr package, most functions in forstringr begin with `str_`. ] <img src="images/example1.jpg" style="display: block; margin: auto;" /> --- class: inverse, middle name: toc ## Functions in the forstringr package - [`length_omit_na()`](#fn1) -- .pull-left[ Substring extraction functions: - [`str_left()`](#fn2) - [`str_right()`](#fn3) - [`str_mid()`](#fn4) ] -- .pull-right[ - [`str_split_extract()`](#fn5) - [`str_extract_part()`](#fn6) - [`str_rm_whitespace_df()`](#fn7) ] --- class: middle ## How to install `forstringr` You can install the development version of forstringr from GitHub with: ```r if (!require("devtools")) { install.packages("devtools") } devtools::install_github("gbganalyst/forstringr") ``` --- class: inverse, middle, center name: fn1 ## `length_omit_na()` <img src="images/logo.png" width="30%" height="25%" style="display: block; margin: auto;" /> --- class: middle ## `length_omit_na()` `length_omitna()` counts only non-missing elements in a vector. **Example 1**: ```r fruits <- c( "Date", "Mangoes", "Apples", "Pineapples", NA, "Bananas", "African cherry", "Matoke", NA, "Tamarind" ) length(`fruits`) ``` ``` [1] 10 ``` ```r length_omit_na(`fruits`) ``` ``` [1] 8 ``` --- ## `length_omit_na()` **Example 2**: ```r drug_list <- read_csv("data/list of drugs.csv") ``` ```r drug_list ``` <table> <thead> <tr> <th style="text-align:left;"> drug_1 </th> <th style="text-align:left;"> drug_2 </th> <th style="text-align:left;"> drug_3 </th> <th style="text-align:left;"> drug_4 </th> <th style="text-align:left;"> drug_5 </th> </tr> </thead> <tbody> <tr> <td style="text-align:left;"> Calcium channel blocker </td> <td style="text-align:left;"> Diuretics </td> <td style="text-align:left;"> ARB </td> <td style="text-align:left;"> Calcium channel blocker </td> <td style="text-align:left;"> NA </td> </tr> <tr> <td style="text-align:left;"> ACE inhibitor </td> <td style="text-align:left;"> Diuretics </td> <td style="text-align:left;"> NA </td> <td style="text-align:left;"> NA </td> <td style="text-align:left;"> NA </td> </tr> <tr> <td style="text-align:left;"> Calcium channel blocker </td> <td style="text-align:left;"> NA </td> <td style="text-align:left;"> NA </td> <td style="text-align:left;"> NA </td> <td style="text-align:left;"> NA </td> </tr> <tr> <td style="text-align:left;"> Diuretics </td> <td style="text-align:left;"> Beta blocker </td> <td style="text-align:left;"> Calcium channel blocker </td> <td style="text-align:left;"> ACE inhibitor </td> <td style="text-align:left;"> NA </td> </tr> <tr> <td style="text-align:left;"> Calcium channel blocker </td> <td style="text-align:left;"> ACE inhibitor </td> <td style="text-align:left;"> NA </td> <td style="text-align:left;"> NA </td> <td style="text-align:left;"> NA </td> </tr> <tr> <td style="text-align:left;"> Calcium channel blocker </td> <td style="text-align:left;"> NA </td> <td style="text-align:left;"> ARB </td> <td style="text-align:left;"> NA </td> <td style="text-align:left;"> NA </td> </tr> <tr> <td style="text-align:left;"> Diuretics </td> <td style="text-align:left;"> Calcium channel blocker </td> <td style="text-align:left;"> Beta blocker </td> <td style="text-align:left;"> ARB </td> <td style="text-align:left;"> NA </td> </tr> <tr> <td style="text-align:left;"> Calcium channel blocker </td> <td style="text-align:left;"> NA </td> <td style="text-align:left;"> NA </td> <td style="text-align:left;"> NA </td> <td style="text-align:left;"> NA </td> </tr> <tr> <td style="text-align:left;"> Diuretics </td> <td style="text-align:left;"> Calcium channel blocker </td> <td style="text-align:left;"> NA </td> <td style="text-align:left;"> NA </td> <td style="text-align:left;"> NA </td> </tr> <tr> <td style="text-align:left;"> Diuretics </td> <td style="text-align:left;"> Calcium channel blocker </td> <td style="text-align:left;"> ACE inhibitor </td> <td style="text-align:left;"> NA </td> <td style="text-align:left;"> NA </td> </tr> <tr> <td style="text-align:left;"> Calcium channel blocker </td> <td style="text-align:left;"> Beta blocker </td> <td style="text-align:left;"> NA </td> <td style="text-align:left;"> Diuretics </td> <td style="text-align:left;"> Diuretics </td> </tr> <tr> <td style="text-align:left;"> Diuretics </td> <td style="text-align:left;"> ACE inhibitor </td> <td style="text-align:left;"> ARNI </td> <td style="text-align:left;"> NA </td> <td style="text-align:left;"> NA </td> </tr> <tr> <td style="text-align:left;"> Calcium channel blocker </td> <td style="text-align:left;"> Diuretics </td> <td style="text-align:left;"> ACE inhibitor </td> <td style="text-align:left;"> NA </td> <td style="text-align:left;"> NA </td> </tr> <tr> <td style="text-align:left;"> ACE inhibitor </td> <td style="text-align:left;"> Calcium channel blocker </td> <td style="text-align:left;"> NA </td> <td style="text-align:left;"> NA </td> <td style="text-align:left;"> NA </td> </tr> <tr> <td style="text-align:left;"> Calcium channel blocker </td> <td style="text-align:left;"> ARB </td> <td style="text-align:left;"> NA </td> <td style="text-align:left;"> NA </td> <td style="text-align:left;"> NA </td> </tr> <tr> <td style="text-align:left;"> Diuretics </td> <td style="text-align:left;"> Calcium channel blocker </td> <td style="text-align:left;"> Diuretics </td> <td style="text-align:left;"> NA </td> <td style="text-align:left;"> NA </td> </tr> <tr> <td style="text-align:left;"> Calcium channel blocker </td> <td style="text-align:left;"> NA </td> <td style="text-align:left;"> NA </td> <td style="text-align:left;"> NA </td> <td style="text-align:left;"> Diuretics </td> </tr> <tr> <td style="text-align:left;"> Diuretics </td> <td style="text-align:left;"> NA </td> <td style="text-align:left;"> ARB </td> <td style="text-align:left;"> Calcium channel blocker </td> <td style="text-align:left;"> NA </td> </tr> <tr> <td style="text-align:left;"> ACE inhibitor </td> <td style="text-align:left;"> Calcium channel blocker </td> <td style="text-align:left;"> Diuretics </td> <td style="text-align:left;"> NA </td> <td style="text-align:left;"> NA </td> </tr> <tr> <td style="text-align:left;"> NA </td> <td style="text-align:left;"> Calcium channel blocker </td> <td style="text-align:left;"> Diuretics </td> <td style="text-align:left;"> NA </td> <td style="text-align:left;"> Diuretics </td> </tr> </tbody> </table> --- ## `length_omit_na()` ```r total_drugs <- drug_list %>% rowwise() %>% mutate(`total` = length_omit_na(unique(c_across(`drug_1`:`drug_5`)))) ``` ```r total_drugs ``` <table> <thead> <tr> <th style="text-align:left;"> drug_1 </th> <th style="text-align:left;"> drug_2 </th> <th style="text-align:left;"> drug_3 </th> <th style="text-align:left;"> drug_4 </th> <th style="text-align:left;"> drug_5 </th> <th style="text-align:right;"> total </th> </tr> </thead> <tbody> <tr> <td style="text-align:left;"> Calcium channel blocker </td> <td style="text-align:left;"> Diuretics </td> <td style="text-align:left;"> ARB </td> <td style="text-align:left;"> Calcium channel blocker </td> <td style="text-align:left;"> NA </td> <td style="text-align:right;"> 3 </td> </tr> <tr> <td style="text-align:left;"> ACE inhibitor </td> <td style="text-align:left;"> Diuretics </td> <td style="text-align:left;"> NA </td> <td style="text-align:left;"> NA </td> <td style="text-align:left;"> NA </td> <td style="text-align:right;"> 2 </td> </tr> <tr> <td style="text-align:left;"> Calcium channel blocker </td> <td style="text-align:left;"> NA </td> <td style="text-align:left;"> NA </td> <td style="text-align:left;"> NA </td> <td style="text-align:left;"> NA </td> <td style="text-align:right;"> 1 </td> </tr> <tr> <td style="text-align:left;"> Diuretics </td> <td style="text-align:left;"> Beta blocker </td> <td style="text-align:left;"> Calcium channel blocker </td> <td style="text-align:left;"> ACE inhibitor </td> <td style="text-align:left;"> NA </td> <td style="text-align:right;"> 4 </td> </tr> <tr> <td style="text-align:left;"> Calcium channel blocker </td> <td style="text-align:left;"> ACE inhibitor </td> <td style="text-align:left;"> NA </td> <td style="text-align:left;"> NA </td> <td style="text-align:left;"> NA </td> <td style="text-align:right;"> 2 </td> </tr> <tr> <td style="text-align:left;"> Calcium channel blocker </td> <td style="text-align:left;"> NA </td> <td style="text-align:left;"> ARB </td> <td style="text-align:left;"> NA </td> <td style="text-align:left;"> NA </td> <td style="text-align:right;"> 2 </td> </tr> <tr> <td style="text-align:left;"> Diuretics </td> <td style="text-align:left;"> Calcium channel blocker </td> <td style="text-align:left;"> Beta blocker </td> <td style="text-align:left;"> ARB </td> <td style="text-align:left;"> NA </td> <td style="text-align:right;"> 4 </td> </tr> <tr> <td style="text-align:left;"> Calcium channel blocker </td> <td style="text-align:left;"> NA </td> <td style="text-align:left;"> NA </td> <td style="text-align:left;"> NA </td> <td style="text-align:left;"> NA </td> <td style="text-align:right;"> 1 </td> </tr> <tr> <td style="text-align:left;"> Diuretics </td> <td style="text-align:left;"> Calcium channel blocker </td> <td style="text-align:left;"> NA </td> <td style="text-align:left;"> NA </td> <td style="text-align:left;"> NA </td> <td style="text-align:right;"> 2 </td> </tr> <tr> <td style="text-align:left;"> Diuretics </td> <td style="text-align:left;"> Calcium channel blocker </td> <td style="text-align:left;"> ACE inhibitor </td> <td style="text-align:left;"> NA </td> <td style="text-align:left;"> NA </td> <td style="text-align:right;"> 3 </td> </tr> <tr> <td style="text-align:left;"> Calcium channel blocker </td> <td style="text-align:left;"> Beta blocker </td> <td style="text-align:left;"> NA </td> <td style="text-align:left;"> Diuretics </td> <td style="text-align:left;"> Diuretics </td> <td style="text-align:right;"> 3 </td> </tr> <tr> <td style="text-align:left;"> Diuretics </td> <td style="text-align:left;"> ACE inhibitor </td> <td style="text-align:left;"> ARNI </td> <td style="text-align:left;"> NA </td> <td style="text-align:left;"> NA </td> <td style="text-align:right;"> 3 </td> </tr> <tr> <td style="text-align:left;"> Calcium channel blocker </td> <td style="text-align:left;"> Diuretics </td> <td style="text-align:left;"> ACE inhibitor </td> <td style="text-align:left;"> NA </td> <td style="text-align:left;"> NA </td> <td style="text-align:right;"> 3 </td> </tr> <tr> <td style="text-align:left;"> ACE inhibitor </td> <td style="text-align:left;"> Calcium channel blocker </td> <td style="text-align:left;"> NA </td> <td style="text-align:left;"> NA </td> <td style="text-align:left;"> NA </td> <td style="text-align:right;"> 2 </td> </tr> <tr> <td style="text-align:left;"> Calcium channel blocker </td> <td style="text-align:left;"> ARB </td> <td style="text-align:left;"> NA </td> <td style="text-align:left;"> NA </td> <td style="text-align:left;"> NA </td> <td style="text-align:right;"> 2 </td> </tr> <tr> <td style="text-align:left;"> Diuretics </td> <td style="text-align:left;"> Calcium channel blocker </td> <td style="text-align:left;"> Diuretics </td> <td style="text-align:left;"> NA </td> <td style="text-align:left;"> NA </td> <td style="text-align:right;"> 2 </td> </tr> <tr> <td style="text-align:left;"> Calcium channel blocker </td> <td style="text-align:left;"> NA </td> <td style="text-align:left;"> NA </td> <td style="text-align:left;"> NA </td> <td style="text-align:left;"> Diuretics </td> <td style="text-align:right;"> 2 </td> </tr> <tr> <td style="text-align:left;"> Diuretics </td> <td style="text-align:left;"> NA </td> <td style="text-align:left;"> ARB </td> <td style="text-align:left;"> Calcium channel blocker </td> <td style="text-align:left;"> NA </td> <td style="text-align:right;"> 3 </td> </tr> <tr> <td style="text-align:left;"> ACE inhibitor </td> <td style="text-align:left;"> Calcium channel blocker </td> <td style="text-align:left;"> Diuretics </td> <td style="text-align:left;"> NA </td> <td style="text-align:left;"> NA </td> <td style="text-align:right;"> 3 </td> </tr> <tr> <td style="text-align:left;"> NA </td> <td style="text-align:left;"> Calcium channel blocker </td> <td style="text-align:left;"> Diuretics </td> <td style="text-align:left;"> NA </td> <td style="text-align:left;"> Diuretics </td> <td style="text-align:right;"> 2 </td> </tr> </tbody> </table> --- class: inverse, middle, center name: fn2 ## `str_left()` <img src="images/logo.png" width="30%" height="25%" style="display: block; margin: auto;" /> --- class: middle # `str_left()` Given a character vector, `str_left()` returns the left side of a string. For examples: **Example 1**: ```r str_left("Nigeria") ``` ``` [1] "N" ``` ```r str_left("Ghana", n = 2) ``` ``` [1] "Gh" ``` ```r str_left(c("Female", "Male", "Male", "Female")) ``` ``` [1] "F" "M" "M" "F" ``` --- ## `str_left()` **Example 2**: ```r disease_subtype <- read_csv("data/ICD-10.csv") ``` ```r disease_subtype ``` <table> <thead> <tr> <th style="text-align:left;"> Disease Subtype </th> <th style="text-align:right;"> Count </th> </tr> </thead> <tbody> <tr> <td style="text-align:left;"> E11 Type 2 Diabetes mellitus </td> <td style="text-align:right;"> 4747 </td> </tr> <tr> <td style="text-align:left;"> I11 Hypertensive heart disease </td> <td style="text-align:right;"> 3323 </td> </tr> <tr> <td style="text-align:left;"> D57 Sickle-cell disorders </td> <td style="text-align:right;"> 2599 </td> </tr> <tr> <td style="text-align:left;"> I42 Cardiomyopathy </td> <td style="text-align:right;"> 329 </td> </tr> <tr> <td style="text-align:left;"> C50 Malignant neoplasm of breast </td> <td style="text-align:right;"> 282 </td> </tr> <tr> <td style="text-align:left;"> E10 Type 1 Diabetes mellitus </td> <td style="text-align:right;"> 142 </td> </tr> <tr> <td style="text-align:left;"> C53 Malignant neoplasm of cervix uteri </td> <td style="text-align:right;"> 128 </td> </tr> <tr> <td style="text-align:left;"> C61 Malignant neoplasm of prostate </td> <td style="text-align:right;"> 120 </td> </tr> <tr> <td style="text-align:left;"> I50 Heart failure </td> <td style="text-align:right;"> 111 </td> </tr> <tr> <td style="text-align:left;"> I50 Heart failure, I11 Hypertensive heart disease, I42 Cardiomyopathy </td> <td style="text-align:right;"> 103 </td> </tr> <tr> <td style="text-align:left;"> I42 Cardiomyopathy </td> <td style="text-align:right;"> 92 </td> </tr> <tr> <td style="text-align:left;"> I63 Cerebral infarction </td> <td style="text-align:right;"> 83 </td> </tr> <tr> <td style="text-align:left;"> I11 Hypertensive heart disease, I42 Cardiomyopathy </td> <td style="text-align:right;"> 75 </td> </tr> <tr> <td style="text-align:left;"> G20 Parkinson disease </td> <td style="text-align:right;"> 74 </td> </tr> <tr> <td style="text-align:left;"> G40 Epilepsy </td> <td style="text-align:right;"> 66 </td> </tr> <tr> <td style="text-align:left;"> I50 Heart failure </td> <td style="text-align:right;"> 52 </td> </tr> <tr> <td style="text-align:left;"> G46 Vascular syndromes of brain in cerebrovascular diseases </td> <td style="text-align:right;"> 49 </td> </tr> <tr> <td style="text-align:left;"> O24 Diabtes mellitus in pregnancy </td> <td style="text-align:right;"> 42 </td> </tr> <tr> <td style="text-align:left;"> I21 Acute myocardial infarction </td> <td style="text-align:right;"> 37 </td> </tr> <tr> <td style="text-align:left;"> C56 Malignant neoplasm of ovary </td> <td style="text-align:right;"> 32 </td> </tr> </tbody> </table> --- ## `str_left()` ```r disease_subtype <- read_csv("data/ICD-10.csv") ``` ```r disease_subtype <- disease_subtype %>% mutate(`ICD-10` = str_left(`Disease Subtype`, 3)) %>% relocate(`ICD-10`, .before = Count) ``` ```r disease_subtype ``` <table> <thead> <tr> <th style="text-align:left;"> Disease Subtype </th> <th style="text-align:left;"> ICD-10 </th> <th style="text-align:right;"> Count </th> </tr> </thead> <tbody> <tr> <td style="text-align:left;"> E11 Type 2 Diabetes mellitus </td> <td style="text-align:left;"> E11 </td> <td style="text-align:right;"> 4747 </td> </tr> <tr> <td style="text-align:left;"> I11 Hypertensive heart disease </td> <td style="text-align:left;"> I11 </td> <td style="text-align:right;"> 3323 </td> </tr> <tr> <td style="text-align:left;"> D57 Sickle-cell disorders </td> <td style="text-align:left;"> D57 </td> <td style="text-align:right;"> 2599 </td> </tr> <tr> <td style="text-align:left;"> I42 Cardiomyopathy </td> <td style="text-align:left;"> I42 </td> <td style="text-align:right;"> 329 </td> </tr> <tr> <td style="text-align:left;"> C50 Malignant neoplasm of breast </td> <td style="text-align:left;"> C50 </td> <td style="text-align:right;"> 282 </td> </tr> <tr> <td style="text-align:left;"> E10 Type 1 Diabetes mellitus </td> <td style="text-align:left;"> E10 </td> <td style="text-align:right;"> 142 </td> </tr> <tr> <td style="text-align:left;"> C53 Malignant neoplasm of cervix uteri </td> <td style="text-align:left;"> C53 </td> <td style="text-align:right;"> 128 </td> </tr> <tr> <td style="text-align:left;"> C61 Malignant neoplasm of prostate </td> <td style="text-align:left;"> C61 </td> <td style="text-align:right;"> 120 </td> </tr> <tr> <td style="text-align:left;"> I50 Heart failure </td> <td style="text-align:left;"> I50 </td> <td style="text-align:right;"> 111 </td> </tr> <tr> <td style="text-align:left;"> I50 Heart failure, I11 Hypertensive heart disease, I42 Cardiomyopathy </td> <td style="text-align:left;"> I50 </td> <td style="text-align:right;"> 103 </td> </tr> <tr> <td style="text-align:left;"> I42 Cardiomyopathy </td> <td style="text-align:left;"> I42 </td> <td style="text-align:right;"> 92 </td> </tr> <tr> <td style="text-align:left;"> I63 Cerebral infarction </td> <td style="text-align:left;"> I63 </td> <td style="text-align:right;"> 83 </td> </tr> <tr> <td style="text-align:left;"> I11 Hypertensive heart disease, I42 Cardiomyopathy </td> <td style="text-align:left;"> I11 </td> <td style="text-align:right;"> 75 </td> </tr> <tr> <td style="text-align:left;"> G20 Parkinson disease </td> <td style="text-align:left;"> G20 </td> <td style="text-align:right;"> 74 </td> </tr> <tr> <td style="text-align:left;"> G40 Epilepsy </td> <td style="text-align:left;"> G40 </td> <td style="text-align:right;"> 66 </td> </tr> <tr> <td style="text-align:left;"> I50 Heart failure </td> <td style="text-align:left;"> I50 </td> <td style="text-align:right;"> 52 </td> </tr> <tr> <td style="text-align:left;"> G46 Vascular syndromes of brain in cerebrovascular diseases </td> <td style="text-align:left;"> G46 </td> <td style="text-align:right;"> 49 </td> </tr> <tr> <td style="text-align:left;"> O24 Diabtes mellitus in pregnancy </td> <td style="text-align:left;"> O24 </td> <td style="text-align:right;"> 42 </td> </tr> <tr> <td style="text-align:left;"> I21 Acute myocardial infarction </td> <td style="text-align:left;"> I21 </td> <td style="text-align:right;"> 37 </td> </tr> <tr> <td style="text-align:left;"> C56 Malignant neoplasm of ovary </td> <td style="text-align:left;"> C56 </td> <td style="text-align:right;"> 32 </td> </tr> </tbody> </table> --- class: inverse, middle, center name: fn3 ## `str_right()` <img src="images/logo.png" width="30%" height="25%" style="display: block; margin: auto;" /> --- ## `str_right()` Given a character vector, `str_right()` returns the right side of a string. **Example 1**: ```r str_right("July 20, 2022", 4) ``` ``` [1] "2022" ``` ```r str_right("Sale Price", n = 5) ``` ``` [1] "Price" ``` --- ## `str_right()` **Example 2**: ```r penguins_visit <- read_csv("data/penguins-visits.csv") ``` ```r penguins_visit ``` <table> <thead> <tr> <th style="text-align:left;"> species </th> <th style="text-align:left;"> island </th> <th style="text-align:left;"> date </th> <th style="text-align:left;"> temperature </th> </tr> </thead> <tbody> <tr> <td style="text-align:left;"> Adelie </td> <td style="text-align:left;"> Biscoe </td> <td style="text-align:left;"> 22/06/2022 </td> <td style="text-align:left;"> 9C </td> </tr> <tr> <td style="text-align:left;"> Gentoo </td> <td style="text-align:left;"> Biscoe </td> <td style="text-align:left;"> 23/06/2022 </td> <td style="text-align:left;"> 8.5C </td> </tr> <tr> <td style="text-align:left;"> Adelie </td> <td style="text-align:left;"> Biscoe </td> <td style="text-align:left;"> 29/06/2022 </td> <td style="text-align:left;"> 8C </td> </tr> <tr> <td style="text-align:left;"> Chinstrap </td> <td style="text-align:left;"> Dream </td> <td style="text-align:left;"> 6/27/2022 </td> <td style="text-align:left;"> 35F </td> </tr> <tr> <td style="text-align:left;"> Gentoo </td> <td style="text-align:left;"> Dream </td> <td style="text-align:left;"> 6/28/2022 </td> <td style="text-align:left;"> 37F </td> </tr> <tr> <td style="text-align:left;"> Adelie </td> <td style="text-align:left;"> Dream </td> <td style="text-align:left;"> 6/29/2022 </td> <td style="text-align:left;"> 38F </td> </tr> <tr> <td style="text-align:left;"> Chinstrap </td> <td style="text-align:left;"> Litchfield </td> <td style="text-align:left;"> 30/06/2022 </td> <td style="text-align:left;"> 12C </td> </tr> <tr> <td style="text-align:left;"> Adelie </td> <td style="text-align:left;"> Torgersen </td> <td style="text-align:left;"> 02/07/2022 </td> <td style="text-align:left;"> 11.5C </td> </tr> <tr> <td style="text-align:left;"> Chinstrap </td> <td style="text-align:left;"> Torgersen </td> <td style="text-align:left;"> 03/07/2022 </td> <td style="text-align:left;"> 10.0C </td> </tr> <tr> <td style="text-align:left;"> Gentoo </td> <td style="text-align:left;"> Torgersen </td> <td style="text-align:left;"> 05/07/2022 </td> <td style="text-align:left;"> 85C </td> </tr> </tbody> </table> --- ## `str_right()` ```r penguins_visit <- read_csv("data/penguins-visits.csv") ``` ```r penguins_visit <- penguins_visit %>% mutate(`temperature_scale` = str_right(`temperature`)) ``` ```r penguins_visit ``` <table> <thead> <tr> <th style="text-align:left;"> species </th> <th style="text-align:left;"> island </th> <th style="text-align:left;"> date </th> <th style="text-align:left;"> temperature </th> <th style="text-align:left;"> temperature_scale </th> </tr> </thead> <tbody> <tr> <td style="text-align:left;"> Adelie </td> <td style="text-align:left;"> Biscoe </td> <td style="text-align:left;"> 22/06/2022 </td> <td style="text-align:left;"> 9C </td> <td style="text-align:left;"> C </td> </tr> <tr> <td style="text-align:left;"> Gentoo </td> <td style="text-align:left;"> Biscoe </td> <td style="text-align:left;"> 23/06/2022 </td> <td style="text-align:left;"> 8.5C </td> <td style="text-align:left;"> C </td> </tr> <tr> <td style="text-align:left;"> Adelie </td> <td style="text-align:left;"> Biscoe </td> <td style="text-align:left;"> 29/06/2022 </td> <td style="text-align:left;"> 8C </td> <td style="text-align:left;"> C </td> </tr> <tr> <td style="text-align:left;"> Chinstrap </td> <td style="text-align:left;"> Dream </td> <td style="text-align:left;"> 6/27/2022 </td> <td style="text-align:left;"> 35F </td> <td style="text-align:left;"> F </td> </tr> <tr> <td style="text-align:left;"> Gentoo </td> <td style="text-align:left;"> Dream </td> <td style="text-align:left;"> 6/28/2022 </td> <td style="text-align:left;"> 37F </td> <td style="text-align:left;"> F </td> </tr> <tr> <td style="text-align:left;"> Adelie </td> <td style="text-align:left;"> Dream </td> <td style="text-align:left;"> 6/29/2022 </td> <td style="text-align:left;"> 38F </td> <td style="text-align:left;"> F </td> </tr> <tr> <td style="text-align:left;"> Chinstrap </td> <td style="text-align:left;"> Litchfield </td> <td style="text-align:left;"> 30/06/2022 </td> <td style="text-align:left;"> 12C </td> <td style="text-align:left;"> C </td> </tr> <tr> <td style="text-align:left;"> Adelie </td> <td style="text-align:left;"> Torgersen </td> <td style="text-align:left;"> 02/07/2022 </td> <td style="text-align:left;"> 11.5C </td> <td style="text-align:left;"> C </td> </tr> <tr> <td style="text-align:left;"> Chinstrap </td> <td style="text-align:left;"> Torgersen </td> <td style="text-align:left;"> 03/07/2022 </td> <td style="text-align:left;"> 10.0C </td> <td style="text-align:left;"> C </td> </tr> <tr> <td style="text-align:left;"> Gentoo </td> <td style="text-align:left;"> Torgersen </td> <td style="text-align:left;"> 05/07/2022 </td> <td style="text-align:left;"> 85C </td> <td style="text-align:left;"> C </td> </tr> </tbody> </table> --- class: inverse, middle, center name: fn4 ## `str_mid()` <img src="images/logo.png" width="30%" height="25%" style="display: block; margin: auto;" /> --- ## `str_mid()` Like in Microsoft Excel, the `str_mid()` returns a specific number of characters from a text string, starting at the position you specify, based on the number of characters you select. **Example 1**: ```r str_mid("Super Eagle", start = 7, n = 5) ``` ``` [1] "Eagle" ``` ```r str_mid("Oyo Ibadan", 5, 6) ``` ``` [1] "Ibadan" ``` --- ## `str_mid()` **Example 2**: ```r error_message <- read_csv("data/Error message.csv") ``` ```r error_message ``` <table> <thead> <tr> <th style="text-align:left;"> source_string </th> <th style="text-align:left;"> error_code </th> </tr> </thead> <tbody> <tr> <td style="text-align:left;"> ERROR:432:Connection timed out </td> <td style="text-align:left;"> ? </td> </tr> <tr> <td style="text-align:left;"> ERROR:450:Unexpected error </td> <td style="text-align:left;"> ? </td> </tr> <tr> <td style="text-align:left;"> ERROR:235:Authentication failed </td> <td style="text-align:left;"> ? </td> </tr> <tr> <td style="text-align:left;"> ERROR:400:Bad Request </td> <td style="text-align:left;"> ? </td> </tr> <tr> <td style="text-align:left;"> ERROR:401:Unauthorized </td> <td style="text-align:left;"> ? </td> </tr> <tr> <td style="text-align:left;"> ERROR:402:Payment Required </td> <td style="text-align:left;"> ? </td> </tr> <tr> <td style="text-align:left;"> ERROR:500:Internal Server Error </td> <td style="text-align:left;"> ? </td> </tr> <tr> <td style="text-align:left;"> ERROR:501:Not Implemented </td> <td style="text-align:left;"> ? </td> </tr> <tr> <td style="text-align:left;"> ERROR:502:Bad Gateway </td> <td style="text-align:left;"> ? </td> </tr> <tr> <td style="text-align:left;"> ERROR:503:Service Unavailable </td> <td style="text-align:left;"> ? </td> </tr> </tbody> </table> --- ## `str_mid()` ```r error_message <- read_csv("data/Error message.csv") ``` ```r error_message <- error_message %>% mutate(`error_code` = str_mid(`source_string`, start = 7, n = 3)) ``` ```r error_message ``` <table> <thead> <tr> <th style="text-align:left;"> source_string </th> <th style="text-align:left;"> error_code </th> </tr> </thead> <tbody> <tr> <td style="text-align:left;"> ERROR:432:Connection timed out </td> <td style="text-align:left;"> 432 </td> </tr> <tr> <td style="text-align:left;"> ERROR:450:Unexpected error </td> <td style="text-align:left;"> 450 </td> </tr> <tr> <td style="text-align:left;"> ERROR:235:Authentication failed </td> <td style="text-align:left;"> 235 </td> </tr> <tr> <td style="text-align:left;"> ERROR:400:Bad Request </td> <td style="text-align:left;"> 400 </td> </tr> <tr> <td style="text-align:left;"> ERROR:401:Unauthorized </td> <td style="text-align:left;"> 401 </td> </tr> <tr> <td style="text-align:left;"> ERROR:402:Payment Required </td> <td style="text-align:left;"> 402 </td> </tr> <tr> <td style="text-align:left;"> ERROR:500:Internal Server Error </td> <td style="text-align:left;"> 500 </td> </tr> <tr> <td style="text-align:left;"> ERROR:501:Not Implemented </td> <td style="text-align:left;"> 501 </td> </tr> <tr> <td style="text-align:left;"> ERROR:502:Bad Gateway </td> <td style="text-align:left;"> 502 </td> </tr> <tr> <td style="text-align:left;"> ERROR:503:Service Unavailable </td> <td style="text-align:left;"> 503 </td> </tr> </tbody> </table> --- class: inverse, middle, center name: fn5 ## `str_split_extract()` <img src="images/logo.png" width="30%" height="25%" style="display: block; margin: auto;" /> --- ## `str_split_extract()` If you want to split up a string into pieces and extract the results using a specific index position, then, you will use `str_split_extract()`. You can interpret it as follows: Given a character string, `S`, extract the element at a given position, `k`, from the result of splitting `S` by a given pattern, `m`. **Example 1**: ```r top_10_richest_nig <- c("Aliko Dangote", "Mike Adenuga", "Femi Otedola", "Arthur Eze", "Abdulsamad Rabiu", "Cletus Ibeto", "Orji Uzor Kalu", "ABC Orjiakor", "Jimoh Ibrahim", "Tony Elumelu") first_name <- str_split_extract(top_10_richest_nig, pattern = " ", position = 1) first_name ``` ``` [1] "Aliko" "Mike" "Femi" "Arthur" "Abdulsamad" [6] "Cletus" "Orji" "ABC" "Jimoh" "Tony" ``` --- ## `str_split_extract()` **Example 2**: ```r product_category <- read_csv("data/product_categories.csv") ``` ```r product_category ``` <table> <thead> <tr> <th style="text-align:left;"> product_key </th> <th style="text-align:left;"> product_id </th> <th style="text-align:left;"> product_category </th> <th style="text-align:left;"> city </th> <th style="text-align:left;"> product_size </th> </tr> </thead> <tbody> <tr> <td style="text-align:left;"> 1334642-AA-BOS-SMALL </td> <td style="text-align:left;"> ? </td> <td style="text-align:left;"> ? </td> <td style="text-align:left;"> ? </td> <td style="text-align:left;"> ? </td> </tr> <tr> <td style="text-align:left;"> 191768-ACA-NYC-MEDIUM </td> <td style="text-align:left;"> ? </td> <td style="text-align:left;"> ? </td> <td style="text-align:left;"> ? </td> <td style="text-align:left;"> ? </td> </tr> <tr> <td style="text-align:left;"> 157263-BBC-BOS-XL </td> <td style="text-align:left;"> ? </td> <td style="text-align:left;"> ? </td> <td style="text-align:left;"> ? </td> <td style="text-align:left;"> ? </td> </tr> <tr> <td style="text-align:left;"> 173372-AA-CHI-SMALL </td> <td style="text-align:left;"> ? </td> <td style="text-align:left;"> ? </td> <td style="text-align:left;"> ? </td> <td style="text-align:left;"> ? </td> </tr> <tr> <td style="text-align:left;"> 135351-BC-NYC-XL </td> <td style="text-align:left;"> ? </td> <td style="text-align:left;"> ? </td> <td style="text-align:left;"> ? </td> <td style="text-align:left;"> ? </td> </tr> <tr> <td style="text-align:left;"> 143105-AC-BOS-LARGE </td> <td style="text-align:left;"> ? </td> <td style="text-align:left;"> ? </td> <td style="text-align:left;"> ? </td> <td style="text-align:left;"> ? </td> </tr> <tr> <td style="text-align:left;"> 17734d772-BB-NYC-MEDIUM </td> <td style="text-align:left;"> ? </td> <td style="text-align:left;"> ? </td> <td style="text-align:left;"> ? </td> <td style="text-align:left;"> ? </td> </tr> <tr> <td style="text-align:left;"> 871837-AB-CHI-XL </td> <td style="text-align:left;"> ? </td> <td style="text-align:left;"> ? </td> <td style="text-align:left;"> ? </td> <td style="text-align:left;"> ? </td> </tr> <tr> <td style="text-align:left;"> 161266-BB-CHI-SMALL </td> <td style="text-align:left;"> ? </td> <td style="text-align:left;"> ? </td> <td style="text-align:left;"> ? </td> <td style="text-align:left;"> ? </td> </tr> <tr> <td style="text-align:left;"> 122892-AA-NYC-MEDIUM </td> <td style="text-align:left;"> ? </td> <td style="text-align:left;"> ? </td> <td style="text-align:left;"> ? </td> <td style="text-align:left;"> ? </td> </tr> <tr> <td style="text-align:left;"> 12830919-AC-CHI-XL </td> <td style="text-align:left;"> ? </td> <td style="text-align:left;"> ? </td> <td style="text-align:left;"> ? </td> <td style="text-align:left;"> ? </td> </tr> <tr> <td style="text-align:left;"> 191999-BB-BOS-LARGE </td> <td style="text-align:left;"> ? </td> <td style="text-align:left;"> ? </td> <td style="text-align:left;"> ? </td> <td style="text-align:left;"> ? </td> </tr> <tr> <td style="text-align:left;"> 111126-BCA-NYC-LARGE </td> <td style="text-align:left;"> ? </td> <td style="text-align:left;"> ? </td> <td style="text-align:left;"> ? </td> <td style="text-align:left;"> ? </td> </tr> <tr> <td style="text-align:left;"> 112283-AB-BOS-MEDIUM </td> <td style="text-align:left;"> ? </td> <td style="text-align:left;"> ? </td> <td style="text-align:left;"> ? </td> <td style="text-align:left;"> ? </td> </tr> </tbody> </table> --- ## `str_split_extract()` Let's extract the city from the product key: ```r product_category <- product_category %>% mutate(`city` = str_split_extract(`product_key`, pattern = "-", position = 3)) ``` ```r product_category ``` <table> <thead> <tr> <th style="text-align:left;"> product_key </th> <th style="text-align:left;"> product_id </th> <th style="text-align:left;"> product_category </th> <th style="text-align:left;"> city </th> <th style="text-align:left;"> product_size </th> </tr> </thead> <tbody> <tr> <td style="text-align:left;"> 1334642-AA-BOS-SMALL </td> <td style="text-align:left;"> ? </td> <td style="text-align:left;"> ? </td> <td style="text-align:left;"> BOS </td> <td style="text-align:left;"> ? </td> </tr> <tr> <td style="text-align:left;"> 191768-ACA-NYC-MEDIUM </td> <td style="text-align:left;"> ? </td> <td style="text-align:left;"> ? </td> <td style="text-align:left;"> NYC </td> <td style="text-align:left;"> ? </td> </tr> <tr> <td style="text-align:left;"> 157263-BBC-BOS-XL </td> <td style="text-align:left;"> ? </td> <td style="text-align:left;"> ? </td> <td style="text-align:left;"> BOS </td> <td style="text-align:left;"> ? </td> </tr> <tr> <td style="text-align:left;"> 173372-AA-CHI-SMALL </td> <td style="text-align:left;"> ? </td> <td style="text-align:left;"> ? </td> <td style="text-align:left;"> CHI </td> <td style="text-align:left;"> ? </td> </tr> <tr> <td style="text-align:left;"> 135351-BC-NYC-XL </td> <td style="text-align:left;"> ? </td> <td style="text-align:left;"> ? </td> <td style="text-align:left;"> NYC </td> <td style="text-align:left;"> ? </td> </tr> <tr> <td style="text-align:left;"> 143105-AC-BOS-LARGE </td> <td style="text-align:left;"> ? </td> <td style="text-align:left;"> ? </td> <td style="text-align:left;"> BOS </td> <td style="text-align:left;"> ? </td> </tr> <tr> <td style="text-align:left;"> 17734d772-BB-NYC-MEDIUM </td> <td style="text-align:left;"> ? </td> <td style="text-align:left;"> ? </td> <td style="text-align:left;"> NYC </td> <td style="text-align:left;"> ? </td> </tr> <tr> <td style="text-align:left;"> 871837-AB-CHI-XL </td> <td style="text-align:left;"> ? </td> <td style="text-align:left;"> ? </td> <td style="text-align:left;"> CHI </td> <td style="text-align:left;"> ? </td> </tr> <tr> <td style="text-align:left;"> 161266-BB-CHI-SMALL </td> <td style="text-align:left;"> ? </td> <td style="text-align:left;"> ? </td> <td style="text-align:left;"> CHI </td> <td style="text-align:left;"> ? </td> </tr> <tr> <td style="text-align:left;"> 122892-AA-NYC-MEDIUM </td> <td style="text-align:left;"> ? </td> <td style="text-align:left;"> ? </td> <td style="text-align:left;"> NYC </td> <td style="text-align:left;"> ? </td> </tr> <tr> <td style="text-align:left;"> 12830919-AC-CHI-XL </td> <td style="text-align:left;"> ? </td> <td style="text-align:left;"> ? </td> <td style="text-align:left;"> CHI </td> <td style="text-align:left;"> ? </td> </tr> <tr> <td style="text-align:left;"> 191999-BB-BOS-LARGE </td> <td style="text-align:left;"> ? </td> <td style="text-align:left;"> ? </td> <td style="text-align:left;"> BOS </td> <td style="text-align:left;"> ? </td> </tr> <tr> <td style="text-align:left;"> 111126-BCA-NYC-LARGE </td> <td style="text-align:left;"> ? </td> <td style="text-align:left;"> ? </td> <td style="text-align:left;"> NYC </td> <td style="text-align:left;"> ? </td> </tr> <tr> <td style="text-align:left;"> 112283-AB-BOS-MEDIUM </td> <td style="text-align:left;"> ? </td> <td style="text-align:left;"> ? </td> <td style="text-align:left;"> BOS </td> <td style="text-align:left;"> ? </td> </tr> </tbody> </table> --- class: inverse, middle, center name: fn6 ## `str_extract_part()` <img src="images/logo.png" width="30%" height="25%" style="display: block; margin: auto;" /> --- ## `str_extract_part()` Extract strings before or after a given pattern. **Example 1**: ```r first_name <- str_extract_part(top_10_richest_nig, before = TRUE, pattern = " ") revenue <- c("$159", "$587", "$891", "$207", "$793") str_extract_part(revenue, before = FALSE, pattern = "$") ``` ``` [1] "159" "587" "891" "207" "793" ``` --- ## `str_extract_part()` **Example 2**: ```r data4email <- read_csv("data/data4email.csv") ``` ```r data4email ``` <table> <thead> <tr> <th style="text-align:left;"> full_name </th> <th style="text-align:left;"> first_name </th> <th style="text-align:left;"> domain </th> <th style="text-align:left;"> email </th> </tr> </thead> <tbody> <tr> <td style="text-align:left;"> Anicet Blessing </td> <td style="text-align:left;"> ? </td> <td style="text-align:left;"> @r4africa.org </td> <td style="text-align:left;"> ? </td> </tr> <tr> <td style="text-align:left;"> Francis Joshua </td> <td style="text-align:left;"> ? </td> <td style="text-align:left;"> @r4africa.org </td> <td style="text-align:left;"> ? </td> </tr> <tr> <td style="text-align:left;"> Chris Brown </td> <td style="text-align:left;"> ? </td> <td style="text-align:left;"> @r4africa.org </td> <td style="text-align:left;"> ? </td> </tr> <tr> <td style="text-align:left;"> Mutiso Bilikisu </td> <td style="text-align:left;"> ? </td> <td style="text-align:left;"> @r4africa.org </td> <td style="text-align:left;"> ? </td> </tr> <tr> <td style="text-align:left;"> Favour Kambeu </td> <td style="text-align:left;"> ? </td> <td style="text-align:left;"> @r4africa.org </td> <td style="text-align:left;"> ? </td> </tr> <tr> <td style="text-align:left;"> Tuli John </td> <td style="text-align:left;"> ? </td> <td style="text-align:left;"> @r4africa.org </td> <td style="text-align:left;"> ? </td> </tr> <tr> <td style="text-align:left;"> Ndaba Ezekiel </td> <td style="text-align:left;"> ? </td> <td style="text-align:left;"> @r4africa.org </td> <td style="text-align:left;"> ? </td> </tr> </tbody> </table> --- ## `str_extract_part()` Let's create email using the first name from the data: ```r data4email <- read_csv("data/data4email.csv") ``` ```r data4email <- data4email %>% mutate(`first_name` = str_extract_part(`full_name`, before = TRUE, pattern = " "), `email` = str_c(`first_name`, `domain`)) ``` ```r data4email ``` <table> <thead> <tr> <th style="text-align:left;"> full_name </th> <th style="text-align:left;"> first_name </th> <th style="text-align:left;"> domain </th> <th style="text-align:left;"> email </th> </tr> </thead> <tbody> <tr> <td style="text-align:left;"> Anicet Blessing </td> <td style="text-align:left;"> Anicet </td> <td style="text-align:left;"> @r4africa.org </td> <td style="text-align:left;"> Anicet@r4africa.org </td> </tr> <tr> <td style="text-align:left;"> Francis Joshua </td> <td style="text-align:left;"> Francis </td> <td style="text-align:left;"> @r4africa.org </td> <td style="text-align:left;"> Francis@r4africa.org </td> </tr> <tr> <td style="text-align:left;"> Chris Brown </td> <td style="text-align:left;"> Chris </td> <td style="text-align:left;"> @r4africa.org </td> <td style="text-align:left;"> Chris@r4africa.org </td> </tr> <tr> <td style="text-align:left;"> Mutiso Bilikisu </td> <td style="text-align:left;"> Mutiso </td> <td style="text-align:left;"> @r4africa.org </td> <td style="text-align:left;"> Mutiso@r4africa.org </td> </tr> <tr> <td style="text-align:left;"> Favour Kambeu </td> <td style="text-align:left;"> Favour </td> <td style="text-align:left;"> @r4africa.org </td> <td style="text-align:left;"> Favour@r4africa.org </td> </tr> <tr> <td style="text-align:left;"> Tuli John </td> <td style="text-align:left;"> Tuli </td> <td style="text-align:left;"> @r4africa.org </td> <td style="text-align:left;"> Tuli@r4africa.org </td> </tr> <tr> <td style="text-align:left;"> Ndaba Ezekiel </td> <td style="text-align:left;"> Ndaba </td> <td style="text-align:left;"> @r4africa.org </td> <td style="text-align:left;"> Ndaba@r4africa.org </td> </tr> </tbody> </table> --- class: inverse, middle, center name: fn7 ## `str_rm_whitespace_df()` <img src="images/logo.png" width="30%" height="25%" style="display: block; margin: auto;" /> --- ## `str_rm_whitespace_df()` .w-100.lh-copy[ Extra spaces are accidentally entered when working with survey data, and problems can arise when evaluating such data because of extra spaces. Therefore, the function `str_rm_whitespace_df()` eliminates your data frame unnecessary leading, trailing, or other whitespaces.] -- 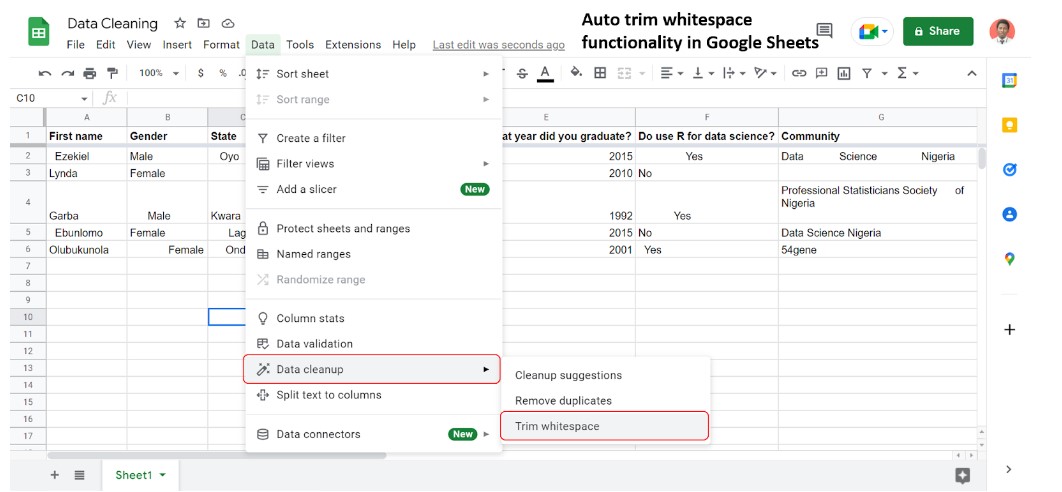<!-- --> --- ## `str_rm_whitespace_df()` **Example 1**: ```r richest_in_nigeria ``` ``` # A tibble: 10 × 5 Rank Name `Net worth` Age `Source of Wealth` <dbl> <chr> <chr> <dbl> <chr> 1 1 " Aliko Dangote" "$14 Billion" 64 " Cement and Sugar " 2 2 "Mike Adenuga" "$7.9 Billion " 68 "Telecommunication, … 3 3 "Femi Otedola" "$5.9 Billion" 59 "Oil and Gas" 4 4 " Arthur Eze" "$5 Billion" 73 "Oil and Gas" 5 5 "Abdulsamad Rabiu" "$3.7 Billion" 61 "Cement and Sugar" 6 6 " Cletus Ibeto " " $3.5 Billion" 69 "Automobile, Real Estat… 7 7 "Orji Uzor Kalu" "$3.2 Billion" 61 "Furniture, Publishi… 8 8 "ABC Orjiakor " " $1.2 Billion" 63 "Oil and Gas" 9 9 " Jimoh Ibrahim" "$1 Billion " 54 "Insurance, Oil and Gas… 10 10 "Tony Elumelu" "$900 Million" 58 " Banking " ``` --- ## `str_rm_whitespace_df()` ```r str_rm_whitespace_df(richest_in_nigeria) ``` <table> <thead> <tr> <th style="text-align:right;"> Rank </th> <th style="text-align:left;"> Name </th> <th style="text-align:left;"> Net worth </th> <th style="text-align:right;"> Age </th> <th style="text-align:left;"> Source of Wealth </th> </tr> </thead> <tbody> <tr> <td style="text-align:right;"> 1 </td> <td style="text-align:left;"> Aliko Dangote </td> <td style="text-align:left;"> $14 Billion </td> <td style="text-align:right;"> 64 </td> <td style="text-align:left;"> Cement and Sugar </td> </tr> <tr> <td style="text-align:right;"> 2 </td> <td style="text-align:left;"> Mike Adenuga </td> <td style="text-align:left;"> $7.9 Billion </td> <td style="text-align:right;"> 68 </td> <td style="text-align:left;"> Telecommunication, Oil, and Gas </td> </tr> <tr> <td style="text-align:right;"> 3 </td> <td style="text-align:left;"> Femi Otedola </td> <td style="text-align:left;"> $5.9 Billion </td> <td style="text-align:right;"> 59 </td> <td style="text-align:left;"> Oil and Gas </td> </tr> <tr> <td style="text-align:right;"> 4 </td> <td style="text-align:left;"> Arthur Eze </td> <td style="text-align:left;"> $5 Billion </td> <td style="text-align:right;"> 73 </td> <td style="text-align:left;"> Oil and Gas </td> </tr> <tr> <td style="text-align:right;"> 5 </td> <td style="text-align:left;"> Abdulsamad Rabiu </td> <td style="text-align:left;"> $3.7 Billion </td> <td style="text-align:right;"> 61 </td> <td style="text-align:left;"> Cement and Sugar </td> </tr> <tr> <td style="text-align:right;"> 6 </td> <td style="text-align:left;"> Cletus Ibeto </td> <td style="text-align:left;"> $3.5 Billion </td> <td style="text-align:right;"> 69 </td> <td style="text-align:left;"> Automobile, Real Estate </td> </tr> <tr> <td style="text-align:right;"> 7 </td> <td style="text-align:left;"> Orji Uzor Kalu </td> <td style="text-align:left;"> $3.2 Billion </td> <td style="text-align:right;"> 61 </td> <td style="text-align:left;"> Furniture, Publishing </td> </tr> <tr> <td style="text-align:right;"> 8 </td> <td style="text-align:left;"> ABC Orjiakor </td> <td style="text-align:left;"> $1.2 Billion </td> <td style="text-align:right;"> 63 </td> <td style="text-align:left;"> Oil and Gas </td> </tr> <tr> <td style="text-align:right;"> 9 </td> <td style="text-align:left;"> Jimoh Ibrahim </td> <td style="text-align:left;"> $1 Billion </td> <td style="text-align:right;"> 54 </td> <td style="text-align:left;"> Insurance, Oil and Gas, Real Estate </td> </tr> <tr> <td style="text-align:right;"> 10 </td> <td style="text-align:left;"> Tony Elumelu </td> <td style="text-align:left;"> $900 Million </td> <td style="text-align:right;"> 58 </td> <td style="text-align:left;"> Banking </td> </tr> </tbody> </table> --- class: inverse, middle, center ## How to contribute <img src="images/logo.png" width="30%" height="25%" style="display: block; margin: auto;" /> --- class: middle ## How to contribute? You can contribute to the development of this package by: .w-100.lh-copy[ - filing an issue if you detect a bug https://github.com/gbganalyst/forstringr/issues. ] -- .w-100.lh-copy[ - if you have any other function that can manipulate strings but does not already exist in any R package, you can also file an issue or create a pull request. ] --- class: center, middle, inverse # The end -- **Thank you**